把 B 站视频和微信公众号文章整理成知识库文摘:我的剪藏工作流
写在前面
我平时会经常逛 B 站视频和微信公众号文章。有些内容确实有价值,但当时没有时间完整看完;有些视频信息密度不高,真正有用的内容可能只占一小段;公众号文章则经常夹着广告和铺垫,想留下的只是其中几段观点。
以前遇到这种内容,我通常先收藏,之后再找时间处理。结果收藏越来越多,真正回头看的却不多。后来我就想,能不能先把内容提取出来,放进自己的 Obsidian 知识库,提炼精华,等有时间时直接阅读精华版。这样至少不会因为错过一次阅读时间,就把这条内容彻底丢掉。甚至未来AI也可以帮我找到这些记忆片段。
所以这篇文章记录的就是我现在使用的剪藏流程。它并不是一个覆盖所有网站的通用方案,主要解决我自己经常遇到的两类内容:B 站视频和微信公众号文章。
灵感来源和用到的工具
最初的想法来自我使用过的WebClipping插件和BilibiliClipper插件。在浏览器里打开youtube视频、B站视频、或者一些网站文章后,可以直接提取已有字幕,整理成文字,再放进 Obsidian。这样我不必先把视频从头看到尾,也可以先快速浏览它到底讲了什么。
然而这样就导致我必须要在电脑前面看视频的时候,才能使用这个功能。其实我觉得这个思路挺适合交给 Agent,于是我就参考它们的工作方式,做成了自用的 Skill。现在大致分成下面几部分:
- Obsidian 负责保存原始文摘、后续整理结果和我的补充笔记。
- web-clipping Skill 中定义了B站视频与微信公众号文章的提取。针对B站,负责识别视频、获取字幕轨、保存字幕文件,并生成一份可以继续编辑的文摘草稿。针对微信公众号文章,则负责提取网页正文,尽量去掉页面噪音,再保存原始内容。
- web-clipping-distiller Skill 负责把原始文摘重新整理成主题、观点、关键事实和行动建议。
“把内容拿回来”和“判断内容值不值得保留”其实是两件事,分开之后更容易排查问题。
OpenCLI:微信公众号剪藏的核心入口
这套流程里还有一个很重要的工具,就是 OpenCLI。前面几个 Skill 负责组织工作流,真正去访问公众号页面、提取正文的核心入口,很多时候就是 OpenCLI。
OpenCLI 是一个开源项目,源码放在 GitHub 上。它基于 Node.js 运行,安装方式比较直接,准备好 Node.js 21 或更高版本后,直接通过 npm 全局安装:
1 | npm install -g @jackwener/opencli |
opencli doctor 主要检查 OpenCLI 本身、浏览器扩展和浏览器桥接是否正常。通常还要安装 OpenCLI 的 Chrome 扩展,并让它连接到正在使用的浏览器。OpenCLI 的优势在于,它既可以调用已经写好的站点适配器,也可以通过浏览器桥接,使用一个真实的、已经登录的 Chrome 页面去读取内容,降低直接请求触发反爬的概率。
如果页面本身可以直接读取,可以先用它的网页读取命令:
1 | opencli web read --url "<文章链接>" |
遇到需要浏览器登录态、页面动态加载,或者普通请求容易触发反爬的情况,我会让 OpenCLI 接管一个浏览器会话。它可以先绑定当前已经打开的 Chrome 标签页,再通过浏览器状态、页面提取或网络请求来拿内容。常见的思路是:
1 | opencli doctor |
这里的 clipper 只是我给这次浏览器会话起的名字,实际使用时可以换成其他名称。浏览器方式的好处是,页面看到的内容和用户手动打开时更接近,公众号文章里的动态正文也更容易拿到。不过它也不是万能的,登录失效、页面没有加载完成、文章本身受权限限制时,仍然需要人工处理。
从一个链接到一篇知识库文摘
我现在的流程大致是:先获取原始内容,再生成文摘草稿,最后根据需要进行蒸馏整理。
原始内容和整理结果会分开保存。原始文摘里保留来源链接、视频字幕或网页正文,尽量不急着删减;蒸馏后的笔记则只保留真正值得长期留下的内容。这样以后发现摘要理解错了,或者想重新整理时,还能回到原文核对。
B 站视频:先拿字幕,再决定要不要看完整视频
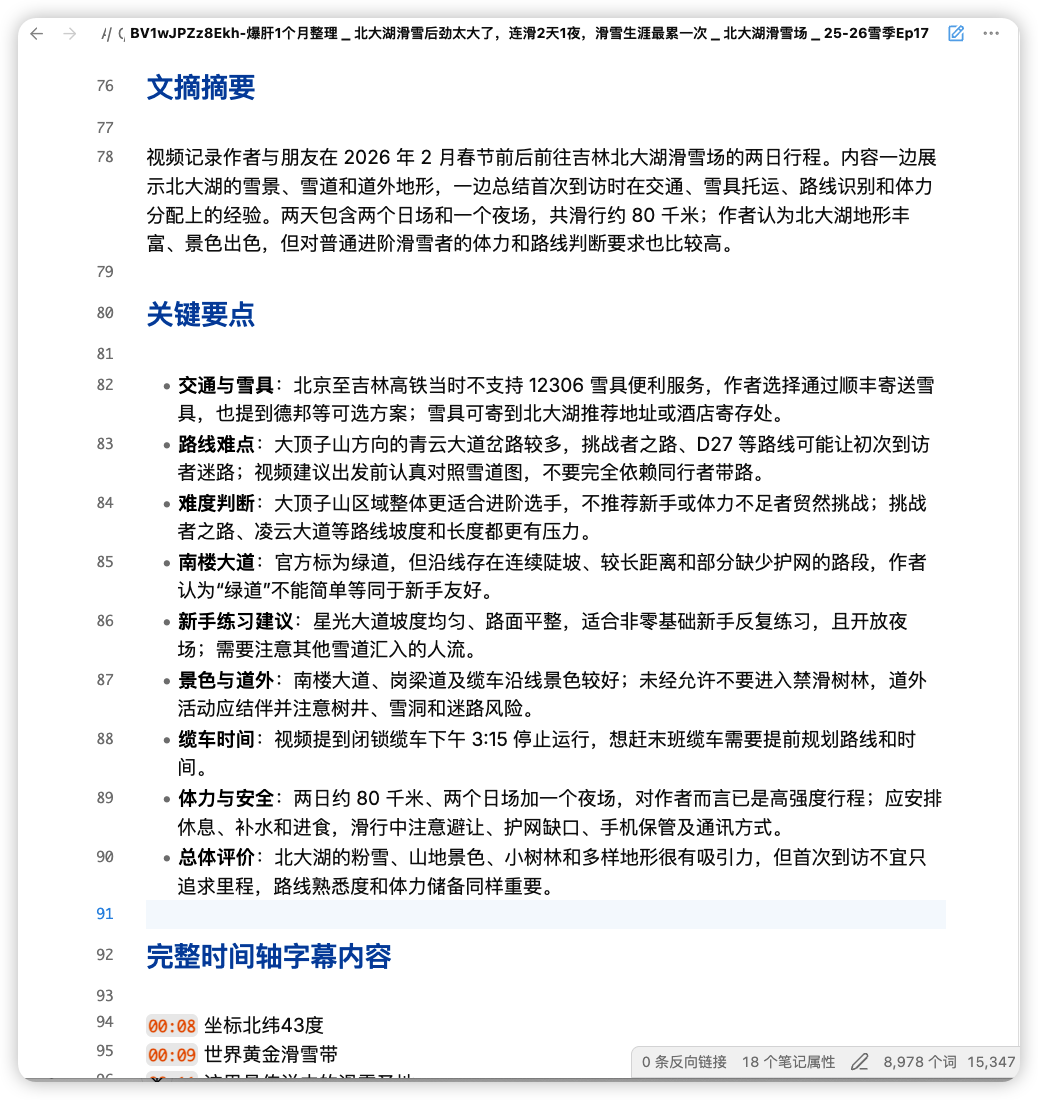
B 站视频的处理难点是字幕。给出一个 B 站链接、短链接或者 BV 号后,剪藏流程会先检查登录状态,再查看这个视频有哪些字幕轨道,最后下载实际可用的字幕。字幕下载下来之后,再生成一份带来源和时间轴的 Markdown 文摘。
这一部分的实现思路,参考了 Bilibili Clipper 这个 Chrome 插件:先拿到视频信息,再处理字幕,最后生成可以放进 Obsidian 的文摘。我后来又让Codex 按照 Agent 的使用方式做了一些改造,主要是补上了扫码登录流程。
现在的处理过程大致分成几步:
- 先从用户输入中识别标准视频链接、短链接或 BV 号。
- 查询视频的基本信息,包括标题、UP 主、发布时间、视频分 P 信息和对应的
aid、cid等标识。 - 检查当前工作目录里有没有可用的登录 Cookie。
- 如果没有登录,Agent 会生成一个登录二维码发给用户;用户扫码确认后,脚本轮询登录结果,把 Cookie 保存到工作目录。
- 登录完成后重新获取字幕轨道,选择可用的中文或 AI 字幕并下载,同时保留字幕来源和时间轴。
- 最后把视频信息、字幕文件路径、视频链接和完整字幕组装成一份 Obsidian 文摘草稿,后续再交给 Agent 补摘要和关键要点。
这套脚本目前还没有放到 GitHub 上。一方面是因为它里面的流程还在调整,另一方面是登录、Cookie 保存和不同字幕轨道的处理还没有整理成适合公开复用的形式。现在它更像是我自己的工作工具,先把逻辑跑通、用顺手,再考虑要不要单独整理成公开项目。另外,这类抓取也可能受到平台规则限制,公开具体实现之前,还需要再确认适合公开的范围。不过不管限制多不多,这一套工作流下来,是真的方便。
微信公众号文章:先保存原文,再清理和整理
微信公众号文章的处理方式就相对比较简单粗暴。它没有字幕轨道,重点是通过 OpenCLI 从页面中提取正文,同时尽量保留标题、段落、引用、图片和原始链接。
要求Agent先让 OpenCLI 把文章保存成原始文摘,确认正文没有明显缺失后,再做摘要和观点整理。公众号文章里经常有广告、推荐阅读和各种页面元素,如果一开始就只保留“看起来有用”的句子,很容易把上下文一起删掉。原文留一份,后面发现摘要不准确时还能重新检查。
公众号文章的正文提取也不是每次都完美。有时候页面访问受限,有时候只拿到了标题和开头,有时候图片或引用没有跟着正文保存下来。遇到这种情况,Agent会先标记为原文不完整,必要时切换到浏览器方式重新抓取,而不是让 Agent 根据残缺内容补写一篇看起来完整的文章。
过程中遇到的几个坑
最常见的是 B 站没有可用字幕,或者字幕质量不太好。自动字幕会有同音字、断句错误和专有名词识别错误。这些也是没有办法的事。不过大部分是正常的我已经知足了。
微信公众号文章的问题主要是正文提取不完整和页面噪音。尤其是图片里的文字、代码截图和嵌套引用,纯文本提取很难完全还原。遇到关键内容时,还是要回到原文或人工确认。
另一个问题是自动摘要容易把事实、作者观点和 Agent 自己的推测混在一起。所以,skill中约定,应当把“原文明确说了什么”“我从中得到的结论”和“还需要核实什么”分开写,不把一份自动生成的摘要直接当成最终知识。
还有一些属于知识库维护的问题:同一篇内容重复剪藏、附件路径变化、原始文摘和蒸馏笔记混在一起,过一段时间之后就很难知道哪份才是来源。现在至少会保留原始链接,原始内容和整理结果也尽量分开存放。
Skill 的编写和改造过程
编写这些 Skill 时,比较重要的是要把输入、输出和失败情况说清楚。例如 B 站剪藏需要明确支持哪些输入格式,工作目录由谁指定,字幕下载失败后应该停在哪里;文摘生成之后,哪些字段需要 Agent 补充,哪些原始字幕不能擅自改写。不过这些要求我都交给Codex了,然后最后的skill其实是Codex帮我慢慢完善的。
最终效果和我的使用感受
现在看到一条 B 站视频或微信公众号文章,我可以直接点击分享链接,手机上直接就发送给我的OpenClaw的Telegram入口,Agent收到链接之后就会判断出来这是B站或者微信公众号文章,就会自动遵循相关skill进行处理了,我就不用操心了。有空的时候打开obsidian,就可以看到相关剪藏已经整理好了,完美!