我的 Obsidian 知识库搭建与多终端同步:Fast Note Sync 实践
其实我是有道云笔记忠实的老用户(但是白嫖版)
有个重要的事实:其实,我是有道云笔记的13年老用户了,自从2013年就开始使用有道云笔记,其中记录了我大量的生活、技术学习、工作笔记和知识沉淀,累计已经有上千篇笔记。所以,我是一直不喜欢更换笔记平台的,因为迁移会很麻烦。不过会员嘛,我是不开的,倒也不是嫌贵,可能就是因为习惯了不付费用笔记了吧。目前不付费的话,一是广告多(忍着),二是客户端智能登录两个设备(电脑上用网页版,不受数量限制),三是markdown文档不允许添加图片(那就不加图片了)。
那么,我为什么要搭建自己的 Obsidian 知识库
我最开始使用 Obsidian 时,还是因为用AI。因为我总是在各种Harness之间切换,也会在不同的终端设备上使用AI,这就会涉及到AI记忆的同步,工作记录的同步。但是这些信息如果使用云同步,就会涉及到一些隐私安全问题。而Obsidian笔记库,因为OpenClaw的火爆出圈,而被顺带着又火了一遍。不过我之前还真没有听说过Obsidian这个软件,可能之前是没有场景去用它吧,毕竟有有道云笔记用的很舒服。但是现在涉及到AI的长期记忆问题了,所以我就终于有场景去用它了,我也就关注到了这个软件。
我给知识库划分了目录,也开始给一些目录补充说明文件。现在这套知识库同时承担几件事:记录自己的生活和学习,保存项目开发过程,整理技术博客素材,还要给 Codex、OpenClaw 等 AI Agent 提供可以持续读取的背景资料。
网上也有很多针对Obsidian知识库的目录结构,还有工作流的分享。但是我觉得这些东西都没有绝对的,适合自己的才是最好的。所以我是进行了一些参考之后,还是选择了从零搭建,在使用的过程中,逐渐的去完善,适合自己的那种使用习惯的话,它才能发挥真正的作用。
先把知识库组织起来,再考虑怎么同步
目前知识库里有我自己的笔记,也有 Agent 记录区、项目工作笔记、运维资料、从有道云笔记导入的旧资料,以及技术博客文章整理区等等。它们的用途不一样,所以我没有把所有内容都堆在一个“笔记”目录里。这个地方网上也有很多人持有不同的意见,有人觉得笔记可以直接平铺,然后通过frontmatter中的Tag之类的东西来进行筛选,还有DataView这种插件可以制作引导页,也可以有可读性。AI也可以直接去按需读取了。但是我对此有不同的看法,因为笔记不只是给AI看的,也是给人看的,必须要人用的也舒服才行。如果你都平铺或者不利于人进行查找的话,那这个笔记就纯粹的失去了它的作用。就变成了纯粹的AI记忆工具了。而且有目录的话,也有利于限制AI的对笔记的各种权限。至于AI的搜索方面的话,其实未来如果笔记很多不容易搜索的话,可以使用本地的Embedding模型进行构建索引,加快语义化的搜索。这个就后面再去尝试吧。
关键目录中的 AGENTS.md 也很重要。因为现在很多Agent比如Codex它会把目录里面的Agents.md这个文件作为操作这个目录内文件的一个子规则。所以我只需要在这相关的重要的目录中增加这种规则,就可以让Agent在读取目录的时候,能够了解到这个目录的内容、作用以及如何操作它,或者有什么注意事项。Agent 也不需要每次都猜这个目录到底是干什么的。
我的多终端使用方式
现在我会在两台 Mac mini、两部 Android 手机、一部鸿蒙手机和一台 Windows 电脑上使用这套知识库。
两台 Mac mini 主要承担桌面端整理、开发和服务运行等工作。老 Mac mini 还长期运行 OpenClaw、Nginx、FRP 和 Fast Note Sync 等自用服务,新 Mac mini 主要负责日常开发、维护和管理。手机更适合临时记录、查看资料和补充灵感,Windows 电脑则作为另一台可以随时接入的桌面开发设备。
我不要求每台设备都承担相同的工作,但希望它们看到的是同一套笔记。比如在手机上记下一条灵感,回到 Mac 上可以继续整理;在电脑上更新项目记录,之后 OpenClaw 或 Codex 也能读取到最新内容。多端同步的意义就在这里,它让我不用先考虑“这条内容应该记在哪台设备上”。
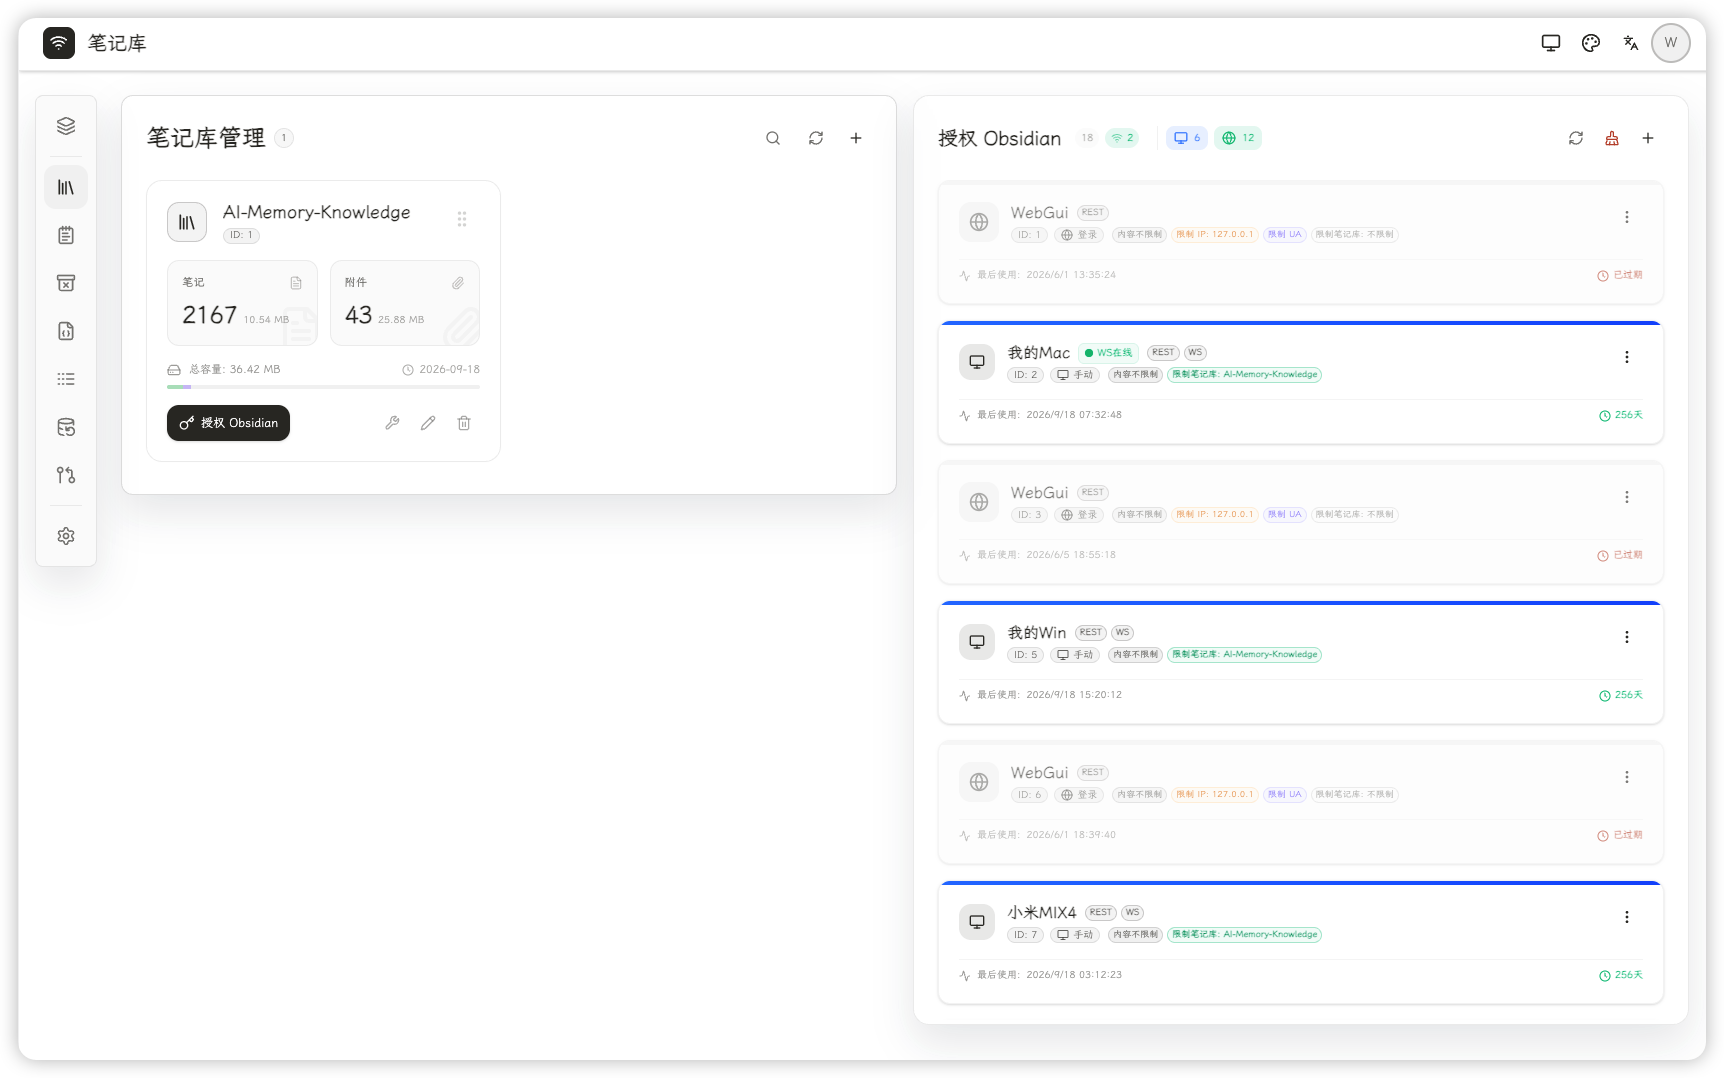
但是问题来了,如何让笔记在这么多设备之间进行同步呢?Obsidian官方提供了同步服务,但是这样会将笔记上到它的云上,而且这个服务是收费的。所以我把目光看向了开源免费的Fast Note Sync。
Fast Note Sync:把同步这件事单独交给一个服务
普通网盘、Git 或手工复制的各种方法显然都是很麻烦不靠谱的。所以最终我使用了开源的 Fast Note Sync。它由 Obsidian 插件和服务端组成,专门负责把知识库文件同步到不同设备。
我现在的链路大致是这样:
1 | 手机 / Windows / 新 Mac mini 上的 Obsidian |
不过,这样可能只是在局域网内可用,跑到公网上也想跑通的话,那就要提前准备好公网IP,或者用云服务搞个FRP之类的内网穿透服务,再说比较安全的方式是tailscale的方式了,这些探讨本文先不展开说了,以后有机会再写写。
我的 FNS 部署方式
Fast Note Sync 的项目主页可以参考作者的官方网站,服务端代码在 fast-note-sync-service 仓库,Obsidian 插件代码在 obsidian-fast-note-sync 仓库。服务端提供了不同系统的 Release 二进制文件,我没有走复杂的安装器,而是直接下载对应版本的二进制文件,放到老 Mac mini 的服务目录里运行。
最开始我直接在终端里进入服务目录,使用二进制文件启动服务,命令大致是这样:
1 | cd /path/to/fast-note-sync-service |
配置文件的位置也固定下来,方便后面排查和备份:
1 | /path/to/fast-note-sync-service/config/config.yaml |
后来我又写了一个 runfns 脚本,把启动、停止、重启、状态检查和日志查看统一起来。脚本的完整内容就不贴了,平时主要使用下面这些命令:
1 | runfns status |
脚本启动时会固定服务的工作目录,并显式指定配置文件。这样做是有必要的,因为配置中如果使用相对路径,换一个工作目录启动,数据和日志可能会落到另一套目录里。
我实际使用的配置里,服务只监听本机端口:
1 | server: |
我没有把同步服务直接暴露到公网,而是让 Nginx 负责 HTTPS 反向代理,再通过 FRP 提供外部访问入口。这样同步服务只需要关注本机的 9000 端口,证书、外部域名和内网穿透分别由前面的组件处理。
这套部署过程中还踩过一个目录方面的坑。刚开始我想把笔记数据放到自定义目录里,修改了配置之后才发现,FNS 并不是所有目录都支持单独指定。有些数据仍然会写回默认目录,结果笔记数据和其他运行数据被分散到了两个位置,后面做备份时很容易漏掉其中一部分。
后来我干脆把数据目录恢复为默认位置,只统一管理默认目录中的笔记数据和配置文件。这样虽然少了一点自定义空间,但备份时只需要围绕一套目录检查,反而更省心。
目前这样部署的话,不需要同步时,可以直接切断FRP转发服务,关闭外部访问,而局域网内还是可以正常运行的。
各个终端的首次接入有点麻烦
新设备接入时,必须先安装 Obsidian 和 Fast Note Sync 插件,填写同步服务地址并登录,然后确认知识库目录已经正确下载。这个环节还是比较麻烦的,可以在手机端登录管理后台的web页面,然后点击一键授权obsidian客户端可以直接跳转obsidian的app,快速配置。
让 Codex、OpenClaw 和其他 Agent 使用同一套知识库
知识库真正变得有用,是从 Agent 能够参与之后开始的。现在 Codex 可以读取项目说明、博客规则和历史工作记录,帮助我整理工作笔记、检查状态或补充项目笔记,将各种编码项目的工作记录都放在了知识库中。OpenClaw 则更适合在日常运行中读取长期资料,配合自己的记忆和定时任务完成一些持续性的工作。
我把整个Obsidian知识库的访问方式、使用规则等等,整理成了一个memory-management技能,提供给我的所有AI Agent使用,我的常用skill是放在共享目录提供给我所有的AI使用的,并且通过私有git同步,从而在各个电脑保持同步,有机会也可以分享一下我的skill整理方法。而豆包、WorkBuddy、ZCode之类的Harness,万一想要偶尔用用,白嫖一下额度来完成一些简单工作的时候,他们也可以通过这些skill直接获取知识库信息,火速了解其他Agent的工作,马上投入工作,进行工作交接,从而达到了知识的高效复用。
而知识库中的目录我也单独划分了权限,有一个目录专门提供给Agent,可以自由修改,而每个agent会根据自己的身份,优先写入对应的目录,这些也是在我的memory-management技能中约定好的。
实际工作流通常是:我先提出一个目标,Agent 找到对应入口和资料,读取规则后再进行整理或修改,最后重新读取目标文件确认结果,比如需要继续搞一个之前的项目,它会找到对应的项目记录,把项目进度梳理出来,然后梳理下一步的建议。
最后
我现在把 Obsidian 当成一个长期使用的资料库,而不是单纯的 Markdown 编辑器。Fast Note Sync 让我可以在不同设备上继续同一套记录,目录说明和 Agent 访问规范则让 Codex、OpenClaw 等工具有机会参与整理工作。
这套东西还没有“搭建完成”的一天。设备会增加,目录会调整,Agent 的能力也会变化。对我来说,最重要的是先让记录足够轻松,再用同步和自动化把后面的整理成本降下来。只要每次新增一点内容,过一段时间还能找得到、看得懂、继续用,这套知识库就算发挥作用了。